中型 AI 算力部署方案
一、产品介绍
中型 AI 算力部署方案面向金融、高端制造、政企科研、多模态业务团队,兼顾高性能训练、高并发实时推理、弹性扩容与数据安全,支撑大模型全量微调、RAG 知识库、多模态生成、工业视觉、智能风控等业务,介于小型单机算力与超大规模智算集群之间,支持私有化本地部署、训推一体、混合云弹性调度,在可控预算内平衡算力密度、网络时延、存储吞吐与合规能力。
硬件选型与算力配置
GPU 集群方案
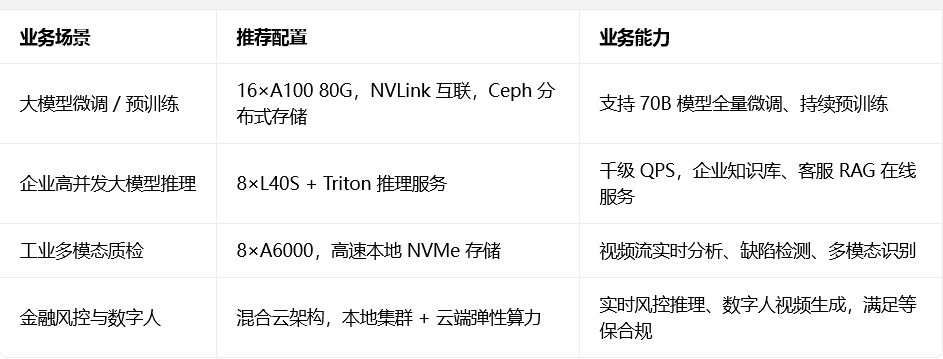
- 训练场景:单机 / 多机集群采用 8–32 卡 NVIDIA H100 / A100 80GB,依靠 NVLink 4.0 高速互联,可稳定承载 70B 参数大模型全量微调,支持多机分布式训练。
- 推理场景:选用 L40S / A6000,搭配 Triton 推理服务器做动态批处理、请求路由、模型版本管理,单机推理 QPS ≥ 1000,适合高并发对话、图像视频多模态推理。
CPU 与存储适配 主控选用 AMD EPYC 9754(128 核)或英特尔至强 Platinum 8592+,标配 1TB DDR5 大容量内存,满足多任务并行、大权重加载、数据集预处理;存储采用高速 NVMe SSD 本地盘(≥10TB),或 Ceph 分布式存储集群,可平滑扩展至 PB 级,保障训练数据集、模型权重、推理日志高速读写。
部署架构设计
混合部署模式
- 训推超融合一体机:可选中兴 AiCube 训推一体机,预装 DeepSeek 系列模型优化套件、主流深度学习框架,打通模型迁移、微调、评估、上线推理全链路,大幅缩短项目部署周期。
- 混合云专属架构:本地私有化集群承载核心敏感数据训练、高频推理;对接公有云昇腾算力,按需弹性拉起临时算力,兼顾数据不出域的安全要求,同时削峰控本。
网络互联优化 集群内部采用 InfiniBand HDR 200G 或 RoCE v2 无损以太网,节点间通信时延 ≤ 2μs,单链路带宽 ≥200Gbps,解决多卡、多机分布式训练通信瓶颈;出口配置 BGP 多线接入 + 物理专线双备份,规避单点断网,保障业务连续性。
软件栈与性能调优
- 框架与工具链 基于 DeepSpeed Zero‑3 显存优化策略,4–8 卡 A100 80G 即可流畅完成 30B 参数模型微调;同时集成昇腾平台推理加速工具,通过专家并行、张量并行、流水线并行组合,将单卡并发承载能力提升 3 倍;配套监控、日志、模型仓库、版本管理一体化平台。
- 能效与量化优化 启用 FP8 混合精度训练,显存占用降低约 30%,整体训练吞吐量提升 40%;推理侧支持 INT8 / FP4 量化压缩,在精度损失可控前提下,推理资源消耗减少 50%,同等硬件承载更高并发。
典型场景与配置示例
安全与运维保障
- 数据合规:方案适配等保 2.3 级建设标准,支持数据本地化存储、TLS 1.3 全链路加密传输、权限细粒度管控、操作审计日志留存;可按需求提供私有化隔离部署,敏感数据不出域。
- 运维服务:7×24 小时专职技术支持,SLA 承诺业务可用性 99.9%,故障响应时效 ≤15 分钟;提供集群巡检、版本升级、模型迁移、性能调优、故障排查全包运维。
总成本控制
硬件整体投入区间:100–500 万元(含 GPU、服务器、高速互联网络、分布式存储集群)。采用混合云模式:业务峰值弹性调用 AWS P5 / Azure ND H100 等公有算力,不用一次性配齐全部峰值硬件,可将初期固定资产投入(CAPEX)降低 60%;同时配套开源监控、调度组件,减少商业软件授权开销。
方案核心优势
训推一体化,一套集群同时承接训练与在线推理;无损高速互联,解决大模型分布式训练通信瓶颈;本地 + 公有云混合调度,兼顾安全与弹性;完整合规能力,适配金融、政务等高要求行业;配套全流程运维托管,降低企业 AI 技术团队门槛;可与 IDC 机房托管、CDN、私有云、服务器代维等产品组合交付。
二、适用场景与目标客户
目标客户群体
银行、证券、保险等金融机构;高端制造、汽车工业、工业集成商;高校科研院所;政务、医疗合规单位;中大型互联网、多模态 AIGC 企业。
细分业务场景
- 大模型自研微调:行业大模型、垂直知识库、私有专属大模型的持续训练、对齐微调;
- 高并发在线推理:企业智能客服、内部文档问答、RAG 知识库、数字人、多模态生成对外服务;
- 工业视觉与质检:流水线图像、视频实时检测,工业缺陷识别、三维视觉分析;
- 金融风控与智能分析:实时风控、交易研判、文档解析,强监管、高审计要求场景;
- 科研与算法迭代:多模态基础模型、自动驾驶仿真、分子仿真、科学计算;
- 混合算力业务:日常负载跑本地集群,大促、模型集训、评测任务临时上云弹性扩容。